


 APP下载

宇树科技王兴兴:机器人行业最大瓶颈是什么?中美机器人的路线之争




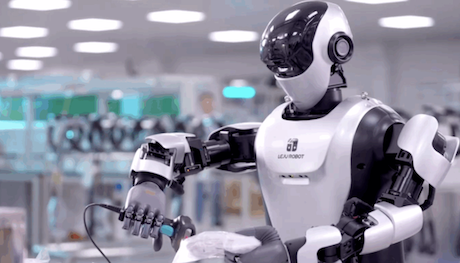
宇树科技王兴兴近期发言称,随着AI与机器人底层技术成熟,大型机器人与小型机器人的研发落地并不冲突。大型机器人是行业不可阻挡的趋势,行业最大的瓶颈,是AI模型输入输出,和真实物理世界之间的精准匹配不足。
在这个最大瓶颈中,中美走的是两条截然相反的路。
2026年9月,Figure AI发布了一组测试数据。搭载Helix 2.5模型的Figure 03机器人在加州湾区30间从未造访过的住宅中,完成了整理玩具、摺毛巾、铺床等420次任务。整体成功率56%。
作为对比,没有使用Index数据集预训练的版本,成功率只有9%。
六倍的提升,来自一个每秒新增35分钟人类行为视频的数据集。 这不是真实机器人采集的数据,而是群众外包的人类行为录像。
这是美国路线的典型样本:用“人类数据”和“仿真数据”替代昂贵的真机采集,用算力换数据。
而在太平洋的另一边,上海浦东的一座数据采集工厂里,数十台人形机器人每天重复着同一批动作:抓起一个杯子、放到指定位置、再抓下一个。采集员通过遥操作设备一遍遍纠正它们的轨迹,机器视觉、关节角度、力控反馈等数据随之汇入后台。
同样的场景,正在成都、无锡、南昌、苏州、天津、北京、深圳等几十个城市同步上演。
中国正在用最“笨”的方式,建造机器人时代最重要的基础设施——物理数据工厂。
一、两条路线的分野:虚拟空间 vs 真实场景
中美在机器人数据策略上的分歧,可以概括为一句话:美国在虚拟世界里“造”数据,中国在真实世界里“攒”数据。
美国路线的核心是世界模型和合成数据。
英伟达的Omniverse Replicator提供了一个框架,让开发者可以生成物理精确的3D合成数据,用于训练机器人的感知网络。2026年3月,英伟达进一步发布了物理AI数据工厂Blueprint,将训练数据的生成、增强和评估流程统一并自动化。全球机器人装机量超200万台的FANUC、ABB Robotics、YASKAWA和KUKA,正在将Omniverse库与Isaac仿真框架集成至其虚拟调试解决方案。
谷歌DeepMind的Genie 3则走得更远。这个“世界模型”可以用简单的图像和文本提示生成可交互的3D环境,模拟真实世界的物理规律。Waymo已经基于Genie 3构建了Waymo World Model,用于模拟龙卷风、洪水、甚至大象等罕见驾驶场景,训练自动驾驶汽车应对极端情况。
这条路线背后的假设是:真实数据太贵太慢,仿真可以替代大部分场景。
中国路线的核心是物理数据采集。
截至2026年6月底,全国已建成启用超过70家具身智能训练场,在建或规划中的还有46家,覆盖18个省级行政区。浙江以14家居首,广东、北京、山东、江苏各有8家,形成长三角、京津冀、珠三角三大集群。
这些训练场不是虚拟的。它们把真实的家庭、工厂、厨房场景1:1搭建出来,让机器人一遍遍练习抓取、叠衣服、拧螺丝。信通院报告用一组测算说明了缺口有多大:假设机器人迎来“ChatGPT时刻”需要训练1.1万亿token的数据,若全部依靠真机采集,约需21200台机器人连续工作一整年。而目前全球可用的高质量真实数据,总共只有数十万到百万小时级。
差距就是机会。而中国的选择是:用规模化的真机部署,把差距填平。
二、为什么仿真数据不够用:物理世界的“意外”无法被预设
这两条路线并非对错之争,而是效率与可靠性之间的权衡。
仿真数据的优势是显而易见的:成本低、产出快、可以无限生成。Figure AI的Index数据集每秒新增35分钟人类行为视频,每天积累5.7年的人类活动记录。这种规模的真实人类数据,是任何真机采集都无法企及的。
但仿真数据有一个无法回避的缺陷:它只能模拟你预设的场景。
宇树科技王兴兴在世界机器人大会上指出了一个关键问题:在固定场景下,经过充分数据采集训练的AI模型任务成功率可接近100%,但一旦更换操作的物品或所处环境,任务成功率就会大幅下降。
这个“泛化瓶颈”的根源,在于仿真环境无法复刻真实世界的全部变量。
物料摆放的微小偏移、光线在金属表面上的反射变化、接触面摩擦力的差异、工件在受力时的细微形变——这些在仿真中要么被忽略,要么被过度简化。但它们恰恰是机器人走进工厂干活时必须面对的常态。
摩根士丹利的评价很直接:大规模组织真机部署、搭建实体数据采集场景的能力,将成为未来人形机器人厂商分出胜负的核心变量。
中国路线的核心优势,不在于数据量更大,在于数据的“物理真实性”。 每一台在真实工厂里运行的机器人,都在产出包含完整物理信号的数据——力觉、触觉、惯性、视觉同步。这些数据无法被仿真生成,因为仿真本身就在模拟一个已经被简化的物理世界。
三、规模:中国制造业土壤的“隐藏资产”
物理数据采集的成本,取决于两个变量:机器人的数量和场景的丰富度。
中国在这两个变量上,都拥有结构性优势。
国际机器人联合会的数据显示,2024年中国新增安装工业机器人29.5万台,同期美国仅新增3.4万台。差距接近九倍。这意味着中国工厂里持续运转的实体机器人数量,以数量级领先于美国。
每一台在产线上工作的机器人,都是一个数据采集终端。 它们每时每刻都在产生视觉、力觉、空间感知、肢体运动的多维原始数据。这些数据不需要专门的采集员去“制造”,它们随着生产活动自然产生。
信通院报告指出,训练场建设逻辑正在从人才、资本驱动,转向以真实场景、数据供给和运营效率为核心的资源配置模式。国家层面,工信部等八部门已明确提出建设人形机器人中试基地和训练场,国家发改委提出以训练场和中试基地为抓手,构建高质量真机数据采集系统。
这是一场由国家意志和制造业土壤共同推动的基础设施建设。
四、王兴兴的判断:瓶颈不在数据量,在匹配精度
宇树科技王兴兴在2026世界机器人大会上给出了一个关于行业瓶颈的精准判断。
他将具身智能的“ChatGPT时刻”定义为:在80%左右的陌生场景中,通过语音和语言指令,机器人能顺利完成约80%的任务。
他认为实现这一目标需要突破三个关键方向:提升模型对任务的表达能力,突破多任务泛化瓶颈;提高模型对多元数据的利用和对齐;提高AI模型与真实机器人的对齐能力。
第三条最值得反复咀嚼。“AI模型与真实机器人的对齐能力”——这正是合成数据与真机数据之间的鸿沟所在。
合成数据在虚拟空间中运行,它训练的模型理解的是一个被简化的物理世界。当真机部署时,模型需要将虚拟世界中学到的“规律”映射到充满噪声、摩擦和非线性的真实物理环境中。这个映射的过程,就是“对齐”。对齐得不好,模型在仿真中表现优异,到了真机上就“水土不服”。
王兴兴的结论是直接的:“有多少数据,就有多少AI能力;数据质量越好,AI能力就越强。”
但他同时承认,人形机器人领域的数据仍然十分稀缺。宇树科技正在做的,是一方面利用海量真人数据和互联网数据进行预训练,另一方面通过真实机器人运行数据让机器人进一步适应物理世界。
五、融合:两条路线正在走向彼此
两条路线的分野清晰,但它们并非完全对立。
Figure AI的Index数据集虽然是人类行为视频,但它采集的是真实人类在真实环境中的操作。这些数据包含了真实物理世界的力反馈和视觉信息,比纯合成的3D场景更接近现实。Figure的成功(成功率从9%到56%)证明,高质量的真实人类数据,可以在一定程度上弥补真机数据的不足。
中国方面,仿真数据同样在被使用。训练场中的机器人练习,往往先在仿真环境中进行预训练,再在真机上做微调和验证。信通院报告援引李飞飞的判断:仿真数据与真实数据是互补关系,但真实数据提供真实世界的物理约束,是模型落地不可替代的部分。
未来的赢家,很可能不是选择某一条路线,而是能把两条路线打通。
用仿真数据做“广覆盖”的预训练,用人类视频数据做“高密度”的行为学习,用真机数据做“精准”的物理对齐。三者叠加,才能同时解决泛化、效率和精度的问题。
六、效率与真实之间的长期博弈
中美机器人数据路线的分歧,本质上是一个关于“如何学习物理世界”的哲学问题。
美国选择用算力和算法“模拟”物理世界。 它的逻辑是:如果仿真足够精确,如果人类数据足够丰富,机器人可以在进入真实世界之前就“学会”大部分技能。这条路线的上限很高,但下限也很低——仿真与现实的差距,可能成为永远无法跨越的鸿沟。
中国选择用部署和场景“采集”物理世界。 它的逻辑是:真实世界的不确定性无法被完全模拟,唯一可靠的学习方式是在真实环境中积累经验。这条路线的上限受制于采集速度和规模,但它的下限很扎实——每一份数据都是真实的物理反馈。
王兴兴说,行业最大的瓶颈是AI模型与真实物理世界的精准匹配不足。这句话点出了这场竞赛的核心:谁能更快地让模型理解真实世界的“不完美”,谁就能更早迎来具身智能的ChatGPT时刻。
两条路线都在向前推进。而最终的结果,可能不是一个路线战胜另一个,而是两条路线在某个节点汇合——仿真提供广度,真机提供精度,人类数据提供密度。 当三者同时到位时,机器人才真正开始“理解”物理世界。
在那之前,70家训练场和每秒35分钟的人类视频,都是这场漫长学习的注脚。
