

 APP下载
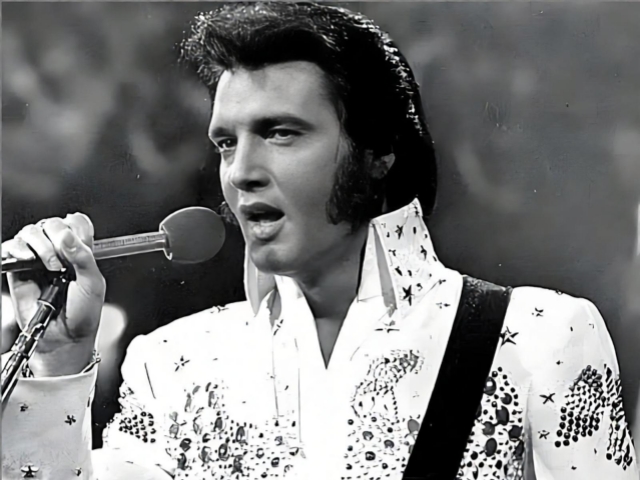
274首歌曲被用于AI训练 猫王起诉Anthropic

“亲爱的,世事如此,有些事是命中注定”,“因为我已情不自禁爱上你”……
这些来自猫王埃尔维斯·普雷斯利1961年经典歌曲《Can’t Help Falling in Love》的歌词,曾属于一个模拟录音与黑胶唱片的时代。可在2026年,它们被卷入一场更冷峻的当代争端:AI 公司是否可以把人类长期积累的音乐作品,直接变成模型训练的免费燃料。
10月23日,猫王音乐作品的版权持有人将美国 AI 公司 Anthropic 告上法庭,指控其未经许可,将274首猫王经典歌曲用于 Claude 模型训练,并要求赔偿近4860万美元。换句话说,AI 公司没有请猫王进录音棚,却把他的作品搬进了自己的训练数据库。
涉案歌曲包括《Can't Help Falling in Love》《Don't Be Cruel》《All Shook Up》和《Return to Sender》等。版权方提出,每首歌曲索赔约15万美元,仅歌曲版权侵权部分就达到4110万美元,此外还包括所谓规避版权保护措施、删除版权信息等方面的赔偿。
Anthropic 对此予以否认,表示将全力应诉。需要强调的是,目前这些指控尚未经过法院认定。
但这场官司引发讨论的重点并非猫王音乐值多少钱,而是更尖锐的问题:AI 公司究竟有没有权利把全人类积累的知识和创造力,当成自己可以随意取用的免费燃料?
AI 企业一直有一套自己的解释:模型训练是在学习规律,而不是简单复制作品。就像一个人听了几千首歌,掌握了音乐创作技巧,并不意味着他侵犯了所有歌手的版权。美国司法界也一直在围绕AI训练是否构成合理使用展开争论。
这个说法并非完全没有道理。毕竟,学习一种音乐风格、研究一种写作技巧,与直接复制一首歌的歌词,是两回事。著作权保护的是具体表达,而不是某种风格本身。
问题在于,Anthropic 这次面对的指控,已经不只是训练数据从哪里来,而是训练之后的 Claude 究竟能生成什么。
诉讼材料称,即使 Anthropic 设置了版权保护机制,Claude 仍然能够根据用户要求,生成与猫王原作高度相似的歌曲。版权方甚至引用了 Claude 的一段回应:生成的版本与原作过于接近,保留了相同的结构、重复使用的副歌旋律和段落安排,只是对歌词进行了轻微修改。
这就有意思了。AI 公司一方面强调自己只是在学习,另一方面却可能让用户得到一首换了几个词、听起来仍然像原作的歌曲。
如果这种行为成立,那么所谓的学习与复制之间,恐怕就不能永远靠一条模糊的技术界线来解决。
更值得注意的是,这已经不是 Anthropic 第一次陷入版权纠纷。此前,环球音乐集团、Concord 等音乐出版商就曾针对其未经授权使用歌词提起诉讼。2025年,Anthropic 还同一批作家就涉嫌使用盗版书籍训练模型达成了15亿美元和解。
这意味着,AI 版权纠纷早已不是某个歌手或某家出版商的个别维权,而是整个行业商业模式必须面对的问题。
猫王这次诉讼还有一个特殊之处:如果连拥有庞大商业资源的猫王版权方,都需要通过联邦法院才能追究 AI 公司的责任,那么普通音乐人、独立创作者又能怎么办?
毕竟,普通创作者既没有能力知道自己的作品是否进入了训练数据库,也很难证明某段 AI 生成内容究竟借鉴了自己的作品,还是恰好相似。AI 公司掌握着模型、数据和技术,创作者却连自己的作品有没有被使用都可能不知道。
更何况,AI 生成音乐已经开始冲击传统音乐市场。AI 可以模仿歌手的声音、重组歌曲结构,甚至批量制造看起来像真人作品的音乐。
Spotify 此前就曾清理约5000万首被认为属于低质量 AI 生成内容的歌曲推荐记录。创作者面临的威胁,已经不只是作品被拿去训练,还包括未来可能被机器制造的廉价替代品挤压市场。
而我们把目光转向中国时,会发现情况更加复杂。
中国并不是没有相关法律。2023年实施的《生成式人工智能服务管理暂行办法》第七条明确要求,AI 企业使用具有合法来源的训练数据,涉及知识产权的,不得侵害他人合法权益。
但事实上,国内已经出现了不少相关纠纷。2024年,广州互联网法院审理的奥特曼 AI 生成图片案;同年,北京互联网法院审理的 AI 绘画大模型训练著作权案件。2025年,爱奇艺又起诉 MiniMax 及其海螺 AI,指控其未经授权使用影视素材训练模型,索赔约10万元。
今年,网红博主星火社在未获得版权授权与许可的情况下,通过改动旋律,重写歌词,并颠倒歌名的方式用 AI 制作的歌曲《五百年沧海桑田》中,AI 到底参与了多少创造令人质疑?事实上,类似的情况在短视频平台中比较普遍。
那么,中国的情况是不是比美国更严重?如果从版权侵权的实际风险和创作者维权难度来看,我认为很可能是。
中国拥有规模庞大的互联网内容生态,短视频、网络文学、音乐、影视、图片和自媒体作品每天都在产生。大量内容被公开发布,却不意味着它们可以被商业化复制、用于模型训练。尤其是海量中小创作者,他们既缺乏追踪数据流向的能力,也缺乏与大型AI企业打官司的资源。
只是,美国的版权诉讼更集中、更成熟,版权方也更有能力通过集体诉讼追责;中国的问题则更多表现为权利人发现困难、取证困难,以及训练数据来源不够透明。可能难度更大。
说到底,AI 行业有一个非常现实的矛盾:它越是想变得聪明,就越离不开人类过去创造的知识、艺术和文化;但它越是成功,原本创造这些价值的人,反而越可能被排除在收益分配之外。
猫王已经无法为自己的歌曲发声,但至少还有版权持有人替他讨个说法。那些没有名气、没有律师、甚至不知道自己作品被 AI 使用过的普通创作者,又该找谁?
AI 可以不付钱就学会猫王的歌吗?这个问题,恐怕比 AI 能不能写出像《Can't Help Falling in Love》那样的歌词“我该留下吗?这会是一种罪吗?”要重要得多。